Más allá de la imagen: la infraestructura que sostiene el abuso con IA
Una lectura del estudio de Morgan, Farid y Nightingale sobre imágenes íntimas sintéticas no consentidas y una propuesta para debatir cómo documentar la infraestructura web con rigor.
Lectura y debate · AEICF
Una imagen manipulada puede ser el punto de partida de una investigación. Pero su circulación depende de una red de servicios que permite publicar una página, mantenerla accesible, encontrarla y obtener ingresos. Mirar esa red abre preguntas relevantes para quienes trabajamos con imagen científica y forense: ¿qué podemos observar?, ¿cómo dejamos constancia de ello? y ¿hasta dónde permite llegar esa evidencia?
Sarah Morgan, Hany Farid y Sophie J. Nightingale abordan esta perspectiva en The Backbone of Abuse: How Infrastructure Providers Enable the Proliferation of AI-Generated Non-Consensual Intimate Imagery, publicado el 30 de septiembre de 2026 en Journal of Online Trust and Safety. Su objeto son las imágenes íntimas sintéticas no consentidas, una forma de abuso en la que la manipulación de la imagen no hace menos real el daño a la persona representada.
Qué estudiaron y qué encontraron
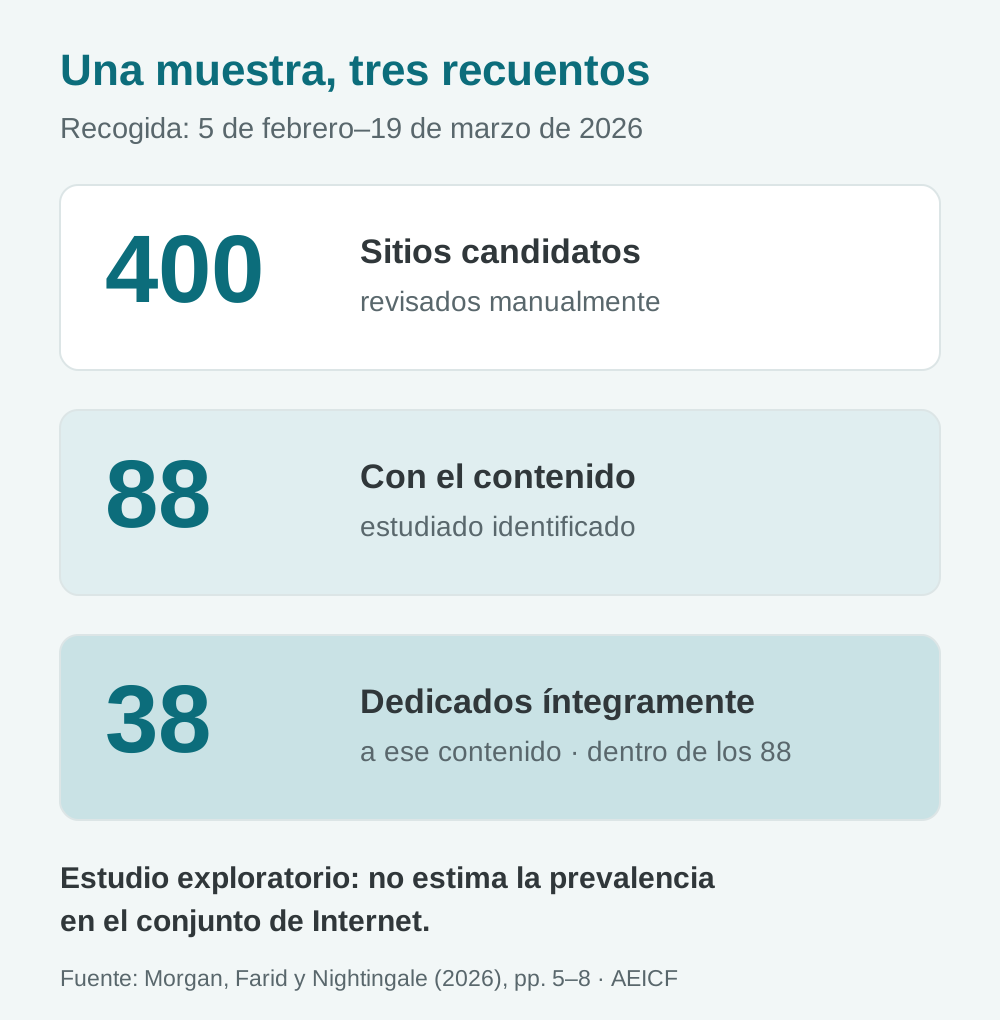
Entre el 5 de febrero y el 19 de marzo de 2026, el equipo revisó manualmente 400 sitios candidatos. Identificó 88 con el contenido estudiado; 38 de ellos estaban dedicados íntegramente a él. La selección partió de alertas y directorios y se amplió con herramientas de dominios similares. Se centró en representaciones de personas famosas y utilizó indicios del sitio y del contenido para su clasificación. El carácter no consentido se apoyó en una presunción razonada sobre esas personas, no en una verificación individual de su consentimiento.
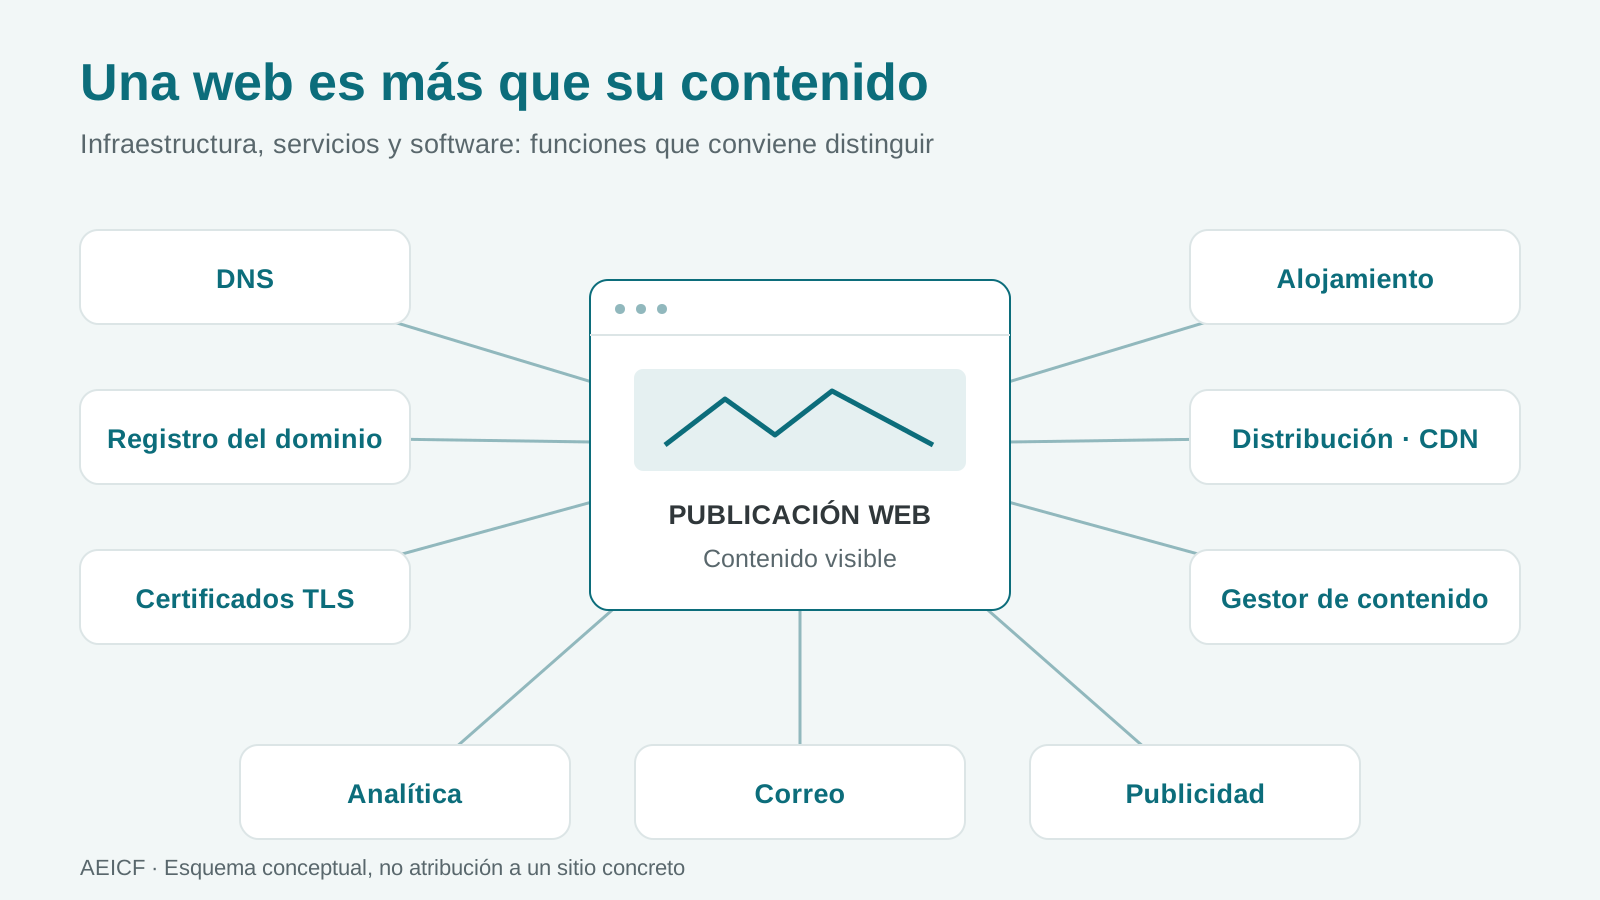
Los autores examinaron nueve componentes: alojamiento, redes de distribución de contenido (CDN), DNS, registro de dominios, certificados SSL, gestores de contenido, analítica, correo y publicidad. Su análisis identifica una concentración de detecciones en determinados proveedores y tecnologías. La figura 1 y el apéndice A del artículo detallan los recuentos y las bases utilizadas para cada servicio.
Tres claves para interpretar los resultados
La muestra no equivale al conjunto de Internet
Estamos ante un estudio exploratorio, con un procedimiento de búsqueda y un periodo de observación definidos. La selección por dominios similares puede introducir sesgos; tampoco permite trasladar sin más los resultados a personas sin presencia pública, espacios privados o sitios no localizados. Su aportación consiste en describir y hacer visible una parte del ecosistema, no en ofrecer un censo universal.
Un porcentaje necesita su denominador
En la categoría que el artículo denomina alojamiento, Cloudflare aparece en 64 de las 105 identificaciones de proveedor: aproximadamente un 61 %. Esa base de 105 no es el número de sitios. Un sitio puede utilizar varios servicios de la misma categoría, y en otras categorías hay información que no se pudo identificar. Presentar todas las proporciones como porcentajes de los 88 sitios cambiaría el significado de los resultados. Véanse la sección 4.1, la figura 1 y la tabla 1 del apéndice.
Encontrar un dominio conocido no mide la exposición cotidiana
Los investigadores localizaron 82 de los 88 sitios en las dos primeras páginas de resultados de Google. Lo hicieron mediante búsquedas construidas a partir de dominios que ya conocían, llegando a introducir su URL completa. El resultado informa sobre su localización con ese protocolo; no mide la probabilidad de que una persona encuentre ese contenido mediante una búsqueda genérica. El procedimiento y sus pasos se explican en la sección 4.4, página 11.
Servicios, intermediarios y software: relaciones diferentes
Para trasladar esta línea de trabajo a la documentación forense, proponemos distinguir con precisión la función observada. Una dirección IP pública puede corresponder a un intermediario que recibe las peticiones y las transmite a otro servidor. Por tanto, detectar esa dirección no identifica por sí solo dónde se conserva el contenido de origen. La documentación de Cloudflare sobre DNS y proxy inverso describe esta separación entre su red y el servidor de origen.
Algo parecido ocurre con los gestores de contenido. Detectar WordPress puede indicar el uso de un programa instalado en un alojamiento de terceros. No demuestra que el sitio esté alojado en WordPress.com. La documentación oficial de WordPress distingue expresamente el software de código abierto del servicio comercial de alojamiento.
Estas cautelas son nuestra propuesta de lectura técnica del estudio. No eliminan el interés de investigar la infraestructura: ayudan a formular relaciones verificables. Conviene separar la observación obtenida de la función que se le atribuye y de cualquier conclusión sobre control, conocimiento o responsabilidad. Esta última requiere evidencia adicional y un análisis específico.
Qué podría acompañar a una captura web
La pregunta que planteamos desde AEICF es si una captura podría resultar más informativa al incorporar una ficha de la infraestructura observada. Sería una línea de trabajo por evaluar, no un procedimiento que este estudio haya validado para nuestras intervenciones.
- Objeto y momento. Página o recurso examinado, fecha, hora y zona horaria. Una relación observada hoy puede haber cambiado cuando vuelva a consultarse.
- Observación conservada. Registro DNS, respuesta HTTP, certificado presentado o fragmento de código pertinente, junto con su fuente y el método de obtención. El dato original permite revisar la interpretación.
- Función atribuida. Diferenciar registro del dominio, DNS, intermediación, alojamiento de origen y software detectado. Cuando la evidencia no permita resolver una función, dejarla expresamente sin determinar.
- Alcance y alternativas. Indicar qué se ha comprobado, qué procede de una herramienta externa y qué explicaciones siguen abiertas. Compartir proveedor o tecnología no prueba por sí solo que dos sitios tengan el mismo operador.
- Conservación y revisión. Documentar herramientas y versiones, preservar los registros necesarios y calcular huellas de integridad. Una huella ayuda a comprobar que un archivo no ha cambiado; no acredita por sí sola que su interpretación sea correcta.
Antes de plantear una investigación habría que contrastar la reproducibilidad de las observaciones, el tratamiento de discrepancias entre herramientas y la información mínima necesaria. También habría que definir cómo proteger los datos de las personas afectadas y evitar que la documentación amplifique la difusión del abuso. La utilidad del contexto técnico depende tanto de lo que permite explicar como de los límites que deja claros.
Lectura original y fuentes
Morgan, S., Farid, H. y Nightingale, S. J. (2026). The Backbone of Abuse: How Infrastructure Providers Enable the Proliferation of AI-Generated Non-Consensual Intimate Imagery. Journal of Online Trust and Safety, 3(4). Publicado el 30 de septiembre de 2026.
- Publicación original y DOI.
- Leer el PDF completo: selección y recogida de datos, páginas 5–8; infraestructura y denominadores, páginas 8–9; búsquedas dirigidas, página 11; ética de la investigación, páginas 25–26; tablas de proveedores, páginas 27–29.
- Cloudflare: funcionamiento del DNS y del proxy inverso.
- WordPress: diferencia entre el software y WordPress.com.
Las ilustraciones son esquemas originales preparados para esta lectura. El gráfico de la muestra utiliza los recuentos publicados por los autores; el esquema de infraestructura es conceptual y no representa una investigación sobre un sitio concreto.