Jenseits des Bildes: die Infrastruktur hinter KI-gestütztem Missbrauch
Eine Betrachtung der Studie von Morgan, Farid und Nightingale über synthetische intime Bilder ohne Einwilligung und ein Vorschlag zur Diskussion darüber, wie sich die Webinfrastruktur sorgfältig dokumentieren lässt.
Lektüre und Debatte · AEICF
Ein manipuliertes Bild kann der Ausgangspunkt einer Untersuchung sein. Seine Verbreitung hängt jedoch von einem Netzwerk aus Diensten ab, das die Veröffentlichung einer Website, ihre Erreichbarkeit und Auffindbarkeit sowie die Erzielung von Einnahmen ermöglicht. Die Betrachtung dieses Netzwerks wirft relevante Fragen für alle auf, die mit wissenschaftlichen und forensischen Bildern arbeiten: Was können wir beobachten? Wie dokumentieren wir es? Und wie weit trägt diese Evidenz?
Sarah Morgan, Hany Farid und Sophie J. Nightingale untersuchen diese Perspektive in The Backbone of Abuse: How Infrastructure Providers Enable the Proliferation of AI-Generated Non-Consensual Intimate Imagery, veröffentlicht am 30. September 2026 im Journal of Online Trust and Safety. Gegenstand ihrer Untersuchung sind nicht einvernehmlich erstellte synthetische Intimbilder – eine Form des Missbrauchs, bei der die Manipulation des Bildes den Schaden für die dargestellte Person nicht weniger real macht.
Was untersucht wurde und welche Ergebnisse vorliegen
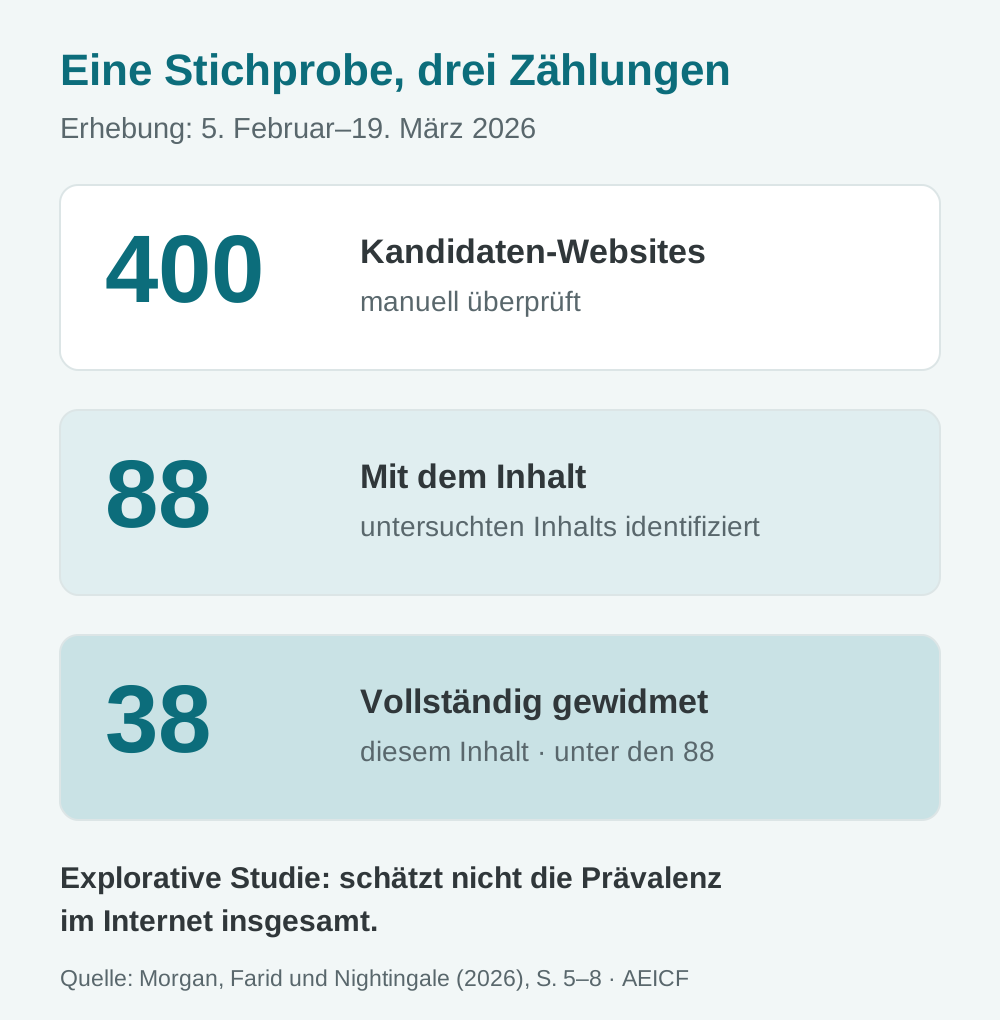
Zwischen dem 5. Februar und dem 19. März 2026 überprüfte das Team 400 potenziell relevante Websites manuell. Es identifizierte 88 mit den untersuchten Inhalten; 38 davon waren diesen Inhalten vollständig gewidmet. Die Auswahl ging von Warnmeldungen und Verzeichnissen aus und wurde mithilfe von Tools zur Suche nach ähnlichen Domains erweitert. Sie konzentrierte sich auf Darstellungen prominenter Personen und nutzte Hinweise auf der Website und in den Inhalten für die Klassifizierung. Die fehlende Einwilligung stützte sich auf eine begründete Annahme in Bezug auf diese Personen, nicht auf eine individuelle Überprüfung ihrer Einwilligung.
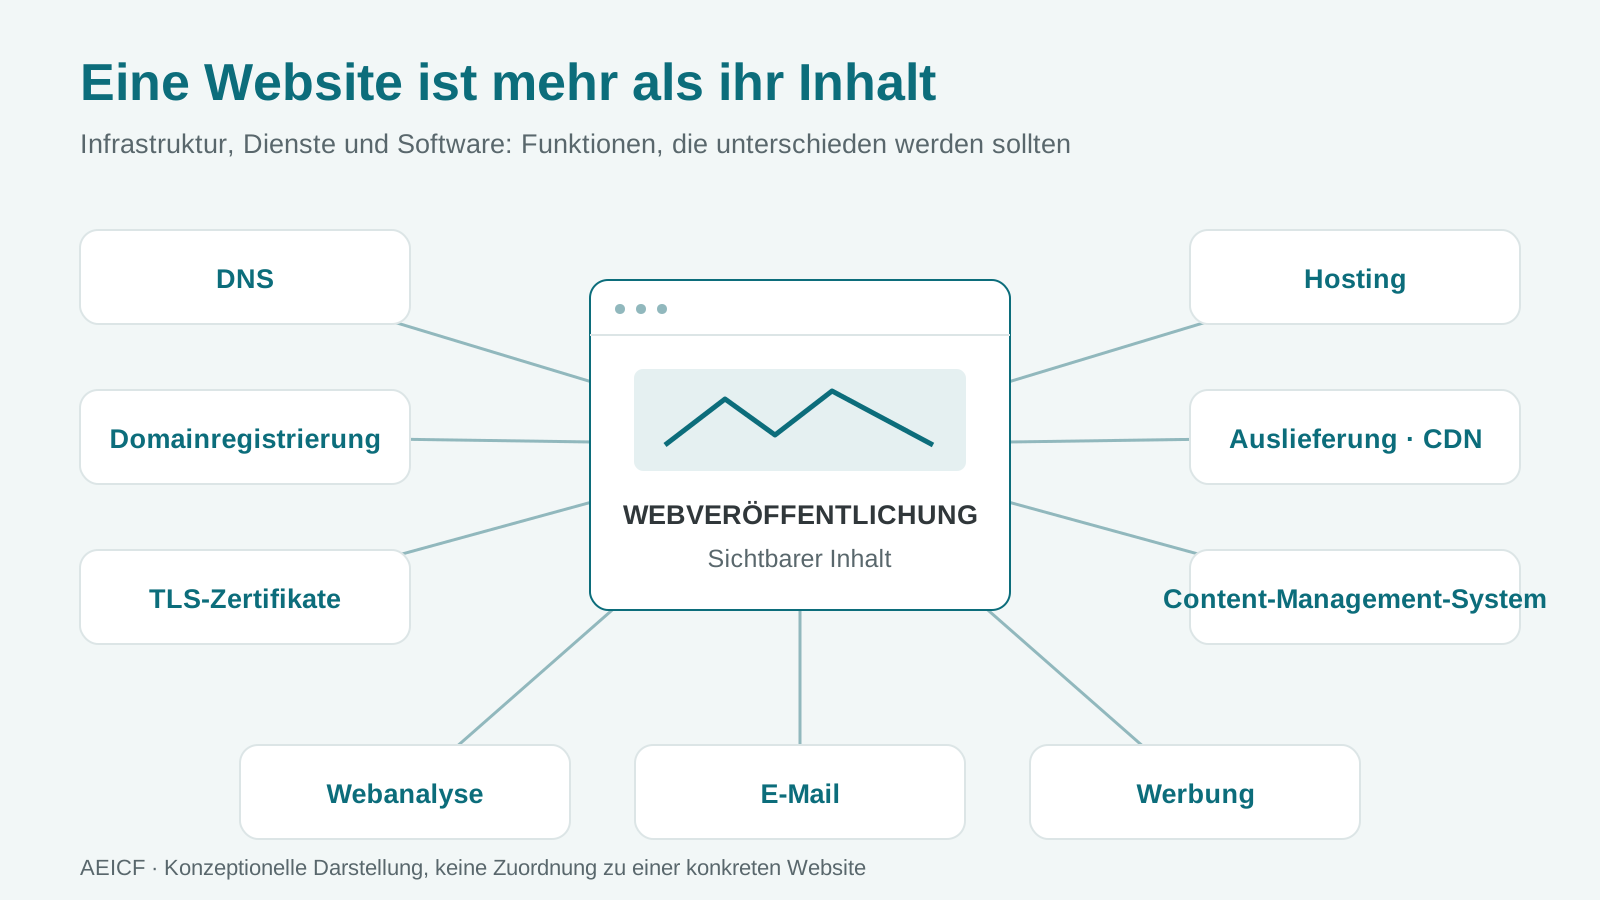
Die Autoren untersuchten neun Komponenten: Hosting, Content Delivery Networks (CDN), DNS, Domainregistrierung, SSL-Zertifikate, Content-Management-Systeme, Analytik, E-Mail und Werbung. Ihre Analyse zeigt, dass bestimmte Anbieter und Technologien besonders häufig festgestellt wurden. Abbildung 1 und Anhang A des Artikels erläutern die Zählungen und die für jeden Dienst verwendeten Bezugsgrößen.
Drei Schlüssel zur Interpretation der Ergebnisse
Die Stichprobe entspricht nicht dem gesamten Internet
Es handelt sich um eine explorative Studie mit einem festgelegten Suchverfahren und Beobachtungszeitraum. Die Auswahl anhand ähnlicher Domains kann zu Verzerrungen führen; zudem lassen sich die Ergebnisse nicht ohne Weiteres auf Personen ohne öffentliche Präsenz, private Bereiche oder nicht aufgefundene Websites übertragen. Der Beitrag der Studie besteht darin, einen Teil des Ökosystems zu beschreiben und sichtbar zu machen, nicht darin, eine vollständige Bestandsaufnahme zu liefern.
Ein Prozentwert braucht seinen Nenner
In der vom Artikel als Hosting bezeichneten Kategorie erscheint Cloudflare bei 64 der 105 Anbieteridentifizierungen: Das entspricht ungefähr 61 %. Diese Bezugsgröße von 105 ist nicht die Anzahl der Websites. Eine Website kann mehrere Dienste derselben Kategorie nutzen, und in anderen Kategorien konnten bestimmte Informationen nicht identifiziert werden. Würden alle Anteile als Prozentsätze der 88 Websites dargestellt, würde sich die Bedeutung der Ergebnisse ändern. Siehe Abschnitt 4.1, Abbildung 1 und Tabelle 1 des Anhangs.
Das Auffinden einer bekannten Domain misst nicht die alltägliche Wahrscheinlichkeit, auf Inhalte zu stoßen
Die Forschenden fanden 82 der 88 Websites auf den ersten beiden Seiten der Google-Suchergebnisse. Dazu verwendeten sie Suchanfragen auf Grundlage bereits bekannter Domains und gaben zum Teil deren vollständige URL ein. Das Ergebnis zeigt, dass die Websites mit diesem Verfahren auffindbar waren; es misst nicht die Wahrscheinlichkeit, dass eine Person diese Inhalte durch eine allgemeine Suche findet. Das Verfahren und seine Schritte werden in Abschnitt 4.4, Seite 11, erläutert.
Dienste, Vermittler und Software: unterschiedliche Beziehungen
Um diesen Forschungsansatz auf die forensische Dokumentation zu übertragen, schlagen wir vor, die beobachtete Funktion genau zu unterscheiden. Eine öffentliche IP-Adresse kann zu einem Vermittler gehören, der Anfragen entgegennimmt und an einen anderen Server weiterleitet. Die Feststellung dieser Adresse allein zeigt daher nicht, wo der ursprüngliche Inhalt gespeichert ist. Die Cloudflare-Dokumentation zu DNS und Reverse-Proxy beschreibt diese Trennung zwischen seinem Netzwerk und dem Ursprungsserver.
Ähnliches gilt für Content-Management-Systeme. Die Feststellung von WordPress kann auf die Nutzung einer Software hinweisen, die bei einem Hosting-Anbieter eines Dritten installiert ist. Sie belegt nicht, dass die Website bei WordPress.com gehostet wird. Die offizielle WordPress-Dokumentation unterscheidet ausdrücklich zwischen der Open-Source-Software und dem kommerziellen Hosting-Dienst.
Diese Vorsichtsaspekte sind unser Vorschlag für eine technische Einordnung der Studie. Sie schmälern nicht das Interesse an einer Untersuchung der Infrastruktur, sondern helfen dabei, überprüfbare Zusammenhänge zu formulieren. Es empfiehlt sich, die gewonnene Beobachtung von der ihr zugeschriebenen Funktion und von Schlussfolgerungen über Kontrolle, Kenntnis oder Verantwortung zu trennen. Letztere erfordern zusätzliche Belege und eine gesonderte Analyse.
Was eine Webseitenerfassung ergänzen könnte
Die Frage, die wir bei AEICF stellen, lautet, ob eine Webseitenerfassung aussagekräftiger sein könnte, wenn sie durch eine Dokumentation der beobachteten Infrastruktur ergänzt würde. Dies wäre ein noch zu prüfender Arbeitsansatz, kein Verfahren, das diese Studie für unsere Einsätze validiert hat.
- Gegenstand und Zeitpunkt. Untersuchte Seite oder Ressource, Datum, Uhrzeit und Zeitzone. Eine heute beobachtete Zuordnung kann sich bei einer erneuten Abfrage bereits geändert haben.
- Gesicherte Beobachtung. DNS-Eintrag, HTTP-Antwort, vorgelegtes Zertifikat oder relevanter Codeausschnitt sowie die jeweilige Quelle und die Methode der Erhebung. Die ursprünglichen Daten ermöglichen es, die Interpretation zu überprüfen.
- Zugeschriebene Funktion. Unterscheidung zwischen Domainregistrierung, DNS, Vermittlung, Hosting des Ursprungsservers und erkannter Software. Wenn die Belege keine Zuordnung einer Funktion erlauben, ist diese ausdrücklich als unbestimmt zu kennzeichnen.
- Umfang und Alternativen. Angabe, was überprüft wurde, was aus einem externen Werkzeug stammt und welche Erklärungen weiterhin offen sind. Ein gemeinsamer Anbieter oder dieselbe Technologie beweisen für sich genommen nicht, dass zwei Websites denselben Betreiber haben.
- Sicherung und Überprüfung. Dokumentation der Werkzeuge und Versionen, Sicherung der erforderlichen Aufzeichnungen und Berechnung von Integritätsprüfwerten. Ein Prüfwert hilft zu überprüfen, ob eine Datei unverändert ist; er belegt für sich genommen nicht, dass ihre Interpretation korrekt ist.
Vor der Planung einer Untersuchung müssten die Reproduzierbarkeit der Beobachtungen, der Umgang mit Abweichungen zwischen Werkzeugen und die mindestens erforderlichen Informationen geprüft werden. Außerdem müsste festgelegt werden, wie die Daten betroffener Personen geschützt und verhindert werden kann, dass die Dokumentation zur weiteren Verbreitung des Missbrauchs beiträgt. Der Nutzen des technischen Kontexts hängt sowohl davon ab, was er zu erklären erlaubt, als auch davon, welche Grenzen er deutlich macht.
Originalpublikation und Quellen
Morgan, S., Farid, H. und Nightingale, S. J. (2026). The Backbone of Abuse: How Infrastructure Providers Enable the Proliferation of AI-Generated Non-Consensual Intimate Imagery. Journal of Online Trust and Safety, 3(4). Veröffentlicht am 30. September 2026.
- Originalpublikation und DOI.
- Das vollständige PDF lesen: Auswahl und Erhebung der Daten, Seiten 5–8; Infrastruktur und Bezugsgrößen, Seiten 8–9; gezielte Suchen, Seite 11; Forschungsethik, Seiten 25–26; Anbietertabellen, Seiten 27–29.
- Cloudflare: Funktionsweise von DNS und Reverse-Proxy.
- WordPress: Unterschied zwischen der Software und WordPress.com.
Die Abbildungen sind eigens für diese Einordnung erstellte schematische Darstellungen. Die Grafik zur Stichprobe verwendet die von den Autoren veröffentlichten Zahlen; das Infrastrukturschema ist konzeptionell und stellt keine Untersuchung einer konkreten Website dar.