Au-delà de l’image : l’infrastructure qui soutient les abus liés à l’IA
Une analyse de l’étude de Morgan, Farid et Nightingale sur les images intimes synthétiques non consenties et une proposition de débat sur la manière de documenter rigoureusement l’infrastructure web.
Lecture et débat · AEICF
Une image manipulée peut être le point de départ d’une enquête. Mais sa circulation dépend d’un réseau de services qui permet de publier une page, de la maintenir accessible, de la trouver et d’en tirer des revenus. L’examen de ce réseau soulève des questions importantes pour les professionnels de l’imagerie scientifique et forensique : que pouvons-nous observer ? Comment en consigner les éléments ? Et jusqu’où ces éléments de preuve permettent-ils d’aller ?
Sarah Morgan, Hany Farid et Sophie J. Nightingale abordent cette perspective dans The Backbone of Abuse: How Infrastructure Providers Enable the Proliferation of AI-Generated Non-Consensual Intimate Imagery, publié le 30 septembre 2026 dans Journal of Online Trust and Safety. Leur étude porte sur les images intimes synthétiques non consenties, une forme d’abus dans laquelle la manipulation de l’image ne rend pas moins réel le préjudice subi par la personne représentée.
Objet et résultats de l’étude
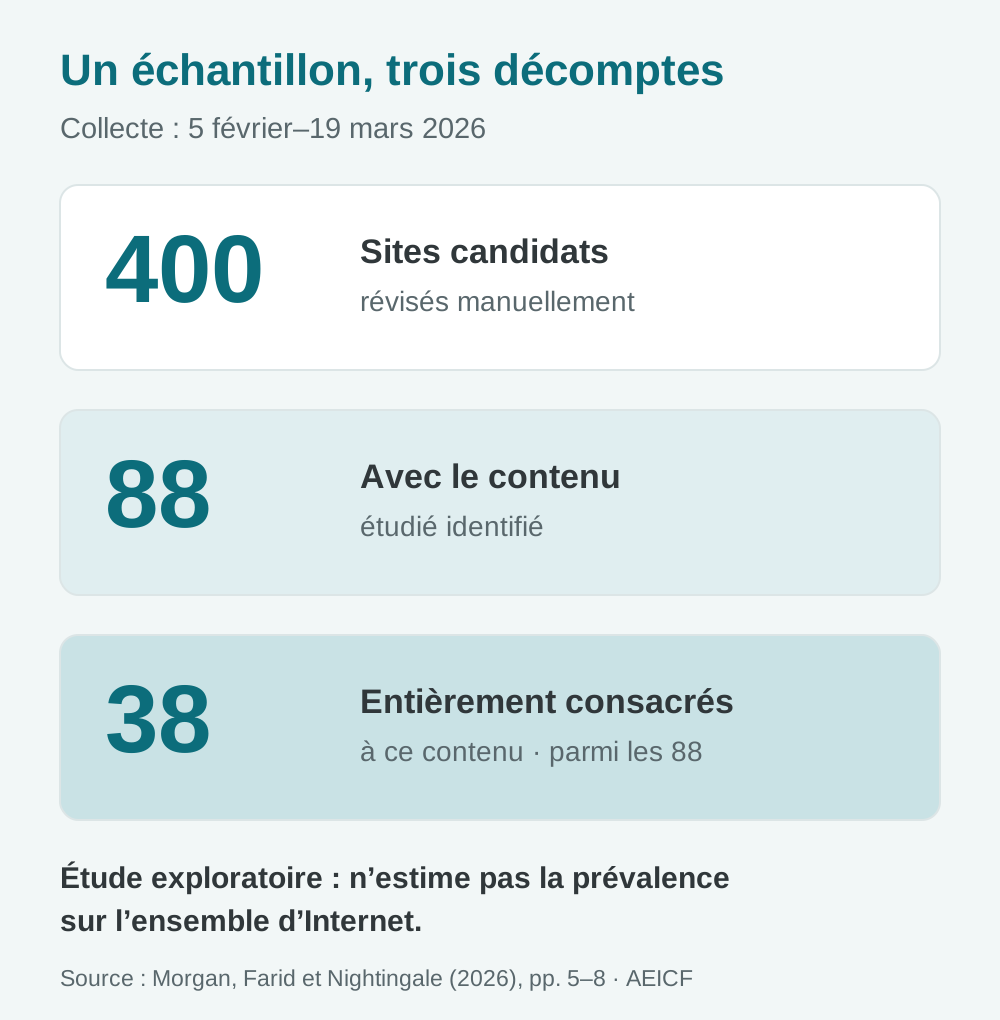
Entre le 5 février et le 19 mars 2026, l’équipe a examiné manuellement 400 sites candidats. Elle en a identifié 88 présentant le contenu étudié, dont 38 lui étaient entièrement consacrés. La sélection s’est appuyée sur des signalements et des répertoires, puis a été élargie à l’aide d’outils de recherche de domaines similaires. Elle s’est concentrée sur des représentations de personnes célèbres et a utilisé des indices tirés des sites et de leur contenu pour les classer. Le caractère non consenti reposait sur une présomption raisonnée concernant ces personnes, et non sur une vérification individuelle de leur consentement.
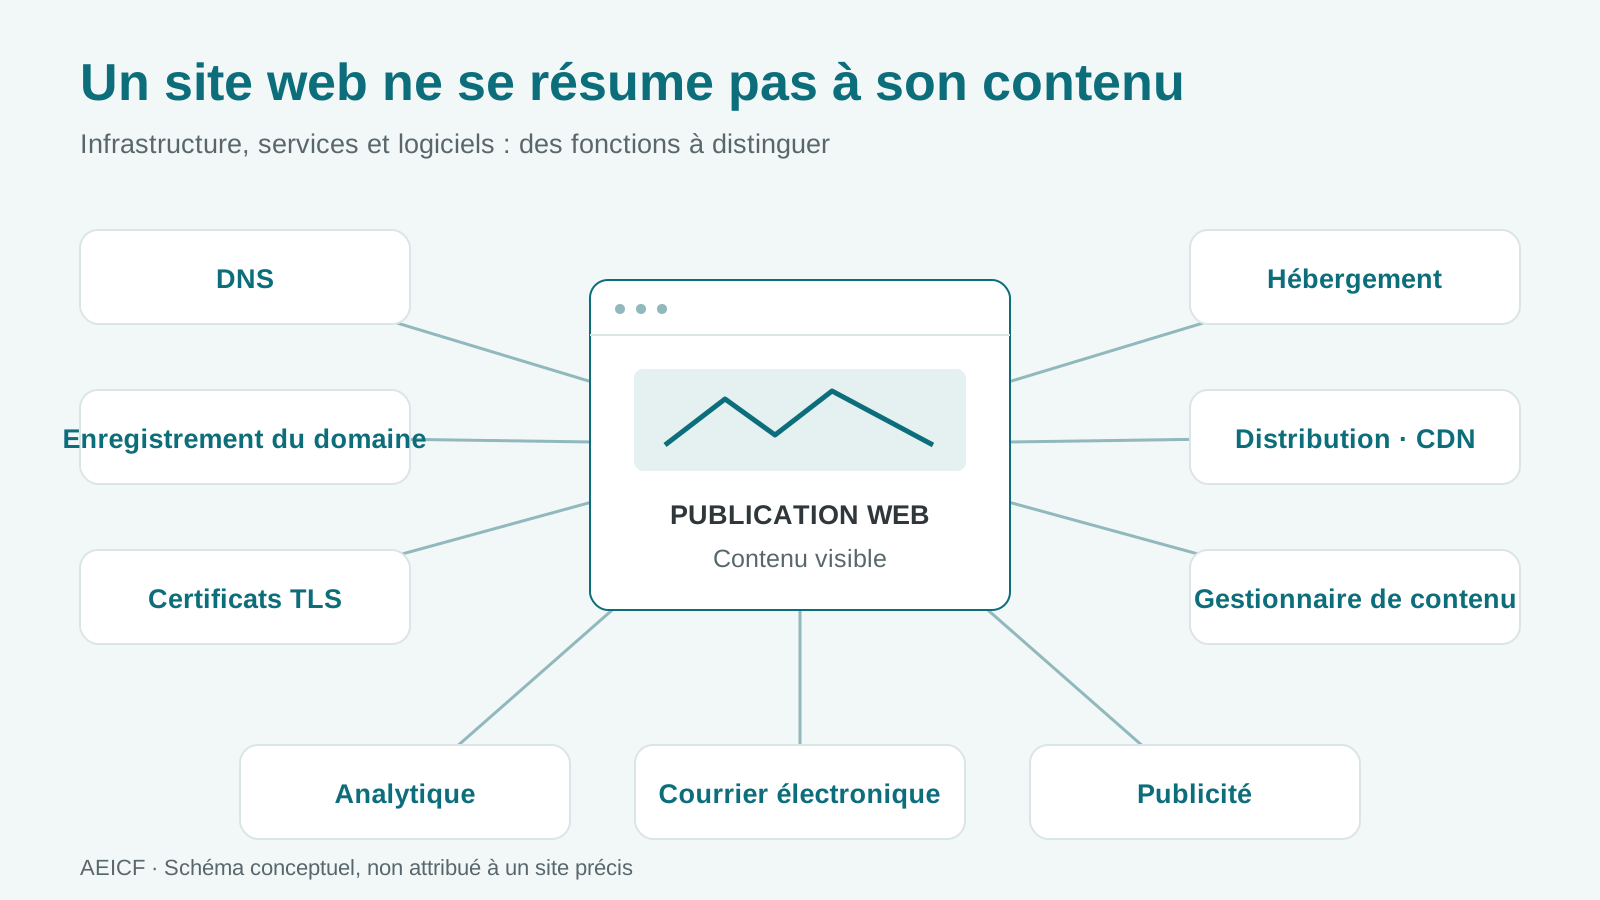
Les auteurs ont examiné neuf composantes : l’hébergement, les réseaux de diffusion de contenu (CDN), le DNS, l’enregistrement de noms de domaine, les certificats SSL, les systèmes de gestion de contenu, l’analyse d’audience, le courrier électronique et la publicité. Leur analyse met en évidence une concentration des détections chez certains fournisseurs et pour certaines technologies. La figure 1 et l’annexe A de l’article détaillent les décomptes et les bases utilisées pour chaque service.
Trois clés pour interpréter les résultats
L’échantillon ne représente pas l’ensemble d’Internet
Il s’agit d’une étude exploratoire fondée sur une procédure de recherche et une période d’observation définies. La sélection par domaines similaires peut introduire des biais ; elle ne permet pas non plus d’appliquer directement les résultats aux personnes sans présence publique, aux espaces privés ou aux sites non localisés. L’étude contribue à décrire et à rendre visible une partie de l’écosystème, sans prétendre en fournir un recensement universel.
Un pourcentage doit être rapporté à son dénominateur
Dans la catégorie que l’article désigne comme l’hébergement, Cloudflare apparaît dans 64 des 105 identifications de fournisseurs, soit environ 61 %. Cette base de 105 ne correspond pas au nombre de sites. Un site peut utiliser plusieurs services d’une même catégorie et, dans d’autres catégories, certaines informations n’ont pas pu être identifiées. Présenter toutes les proportions en pourcentage des 88 sites modifierait le sens des résultats. Voir la section 4.1, la figure 1 et le tableau 1 de l’annexe.
Trouver un domaine connu ne mesure pas l’exposition quotidienne
Les chercheurs ont localisé 82 des 88 sites dans les deux premières pages de résultats de Google. Ils ont effectué des recherches à partir de domaines qu’ils connaissaient déjà, allant jusqu’à saisir leur URL complète. Ce résultat indique dans quelle mesure les sites ont été localisés selon ce protocole ; il ne mesure pas la probabilité qu’une personne trouve ce contenu au moyen d’une recherche générique. La procédure et ses étapes sont expliquées à la section 4.4, page 11.
Services, intermédiaires et logiciels : des relations distinctes
Pour appliquer cette démarche à la documentation forensique, nous proposons de distinguer avec précision la fonction observée. Une adresse IP publique peut correspondre à un intermédiaire qui reçoit les requêtes et les transmet à un autre serveur. Par conséquent, la détection de cette adresse ne permet pas, à elle seule, de déterminer où le contenu d’origine est conservé. La documentation de Cloudflare sur le DNS et le proxy inverse décrit cette séparation entre son réseau et le serveur d’origine.
Il en va de même pour les systèmes de gestion de contenu. La détection de WordPress peut indiquer l’utilisation d’un logiciel installé sur un hébergement tiers. Elle ne prouve pas que le site est hébergé sur WordPress.com. La documentation officielle de WordPress distingue expressément le logiciel libre du service commercial d’hébergement.
Ces précautions constituent notre proposition de lecture technique de l’étude. Elles ne remettent pas en cause l’intérêt d’examiner l’infrastructure : elles aident à formuler des liens vérifiables. Il convient de distinguer l’observation recueillie, la fonction qui lui est attribuée et toute conclusion concernant le contrôle, la connaissance ou la responsabilité. Cette dernière exige des éléments de preuve supplémentaires et une analyse spécifique.
Ce qui pourrait accompagner une capture de page web
La question que nous posons chez AEICF est de savoir si une capture pourrait être plus informative si elle était accompagnée d’une fiche décrivant l’infrastructure observée. Ce serait une piste de travail à évaluer, et non une procédure que cette étude aurait validée pour nos interventions.
- Objet et moment. Page ou ressource examinée, date, heure et fuseau horaire. Un lien observé aujourd’hui peut avoir changé lors d’une consultation ultérieure.
- Observation conservée. Enregistrement DNS, réponse HTTP, certificat présenté ou fragment de code pertinent, ainsi que sa source et la méthode d’obtention. La donnée originale permet de réexaminer l’interprétation.
- Fonction attribuée. Distinguer l’enregistrement du domaine, le DNS, l’intermédiation, l’hébergement d’origine et les logiciels détectés. Lorsque les éléments de preuve ne permettent pas d’établir une fonction, la laisser expressément indéterminée.
- Portée et autres explications. Indiquer ce qui a été vérifié, ce qui provient d’un outil externe et les explications qui restent possibles. Le partage d’un fournisseur ou d’une technologie ne prouve pas à lui seul que deux sites ont le même exploitant.
- Conservation et révision. Documenter les outils et leurs versions, préserver les enregistrements nécessaires et calculer des empreintes d’intégrité. Une empreinte aide à vérifier qu’un fichier n’a pas changé ; elle ne prouve pas à elle seule que son interprétation est correcte.
Avant d’envisager une investigation, il faudrait vérifier la reproductibilité des observations, le traitement des divergences entre outils et les informations minimales nécessaires. Il faudrait également définir comment protéger les données des personnes concernées et éviter que la documentation n’amplifie la diffusion des contenus abusifs. L’utilité du contexte technique dépend autant de ce qu’il permet d’expliquer que des limites qu’il établit clairement.
Lecture originale et sources
Morgan, S., Farid, H. et Nightingale, S. J. (2026). The Backbone of Abuse: How Infrastructure Providers Enable the Proliferation of AI-Generated Non-Consensual Intimate Imagery. Journal of Online Trust and Safety, 3(4). Publié le 30 septembre 2026.
- Publication originale et DOI.
- Lire le PDF complet: sélection et collecte des données, pages 5–8 ; infrastructure et dénominateurs, pages 8–9 ; recherches ciblées, page 11 ; éthique de la recherche, pages 25–26 ; tableaux des fournisseurs, pages 27–29.
- Cloudflare : fonctionnement du DNS et du proxy inverse.
- WordPress : différence entre le logiciel et WordPress.com.
Les illustrations sont des schémas originaux préparés pour cette lecture. Le graphique de l’échantillon utilise les effectifs publiés par les auteurs ; le schéma d’infrastructure est conceptuel et ne représente pas une investigation portant sur un site particulier.