Para além da imagem: a infraestrutura que sustenta o abuso com IA
Uma leitura do estudo de Morgan, Farid e Nightingale sobre imagens íntimas sintéticas não consentidas e uma proposta para debater como documentar a infraestrutura web com rigor.
Leitura e debate · AEICF
Uma imagem manipulada pode ser o ponto de partida de uma investigação. Mas a sua circulação depende de uma rede de serviços que permite publicar uma página, mantê-la acessível, encontrá-la e obter receitas. Observar essa rede suscita questões relevantes para quem trabalha com imagem científica e forense: o que podemos observar? Como o documentamos? E até onde nos permite chegar essa evidência?
Sarah Morgan, Hany Farid e Sophie J. Nightingale abordam esta perspetiva em The Backbone of Abuse: How Infrastructure Providers Enable the Proliferation of AI-Generated Non-Consensual Intimate Imagery, publicado a 30 de Setembro de 2026 no Journal of Online Trust and Safety. O estudo centra-se em imagens íntimas sintéticas não consentidas, uma forma de abuso em que a manipulação da imagem não torna menos real o dano causado à pessoa representada.
O que estudaram e o que encontraram
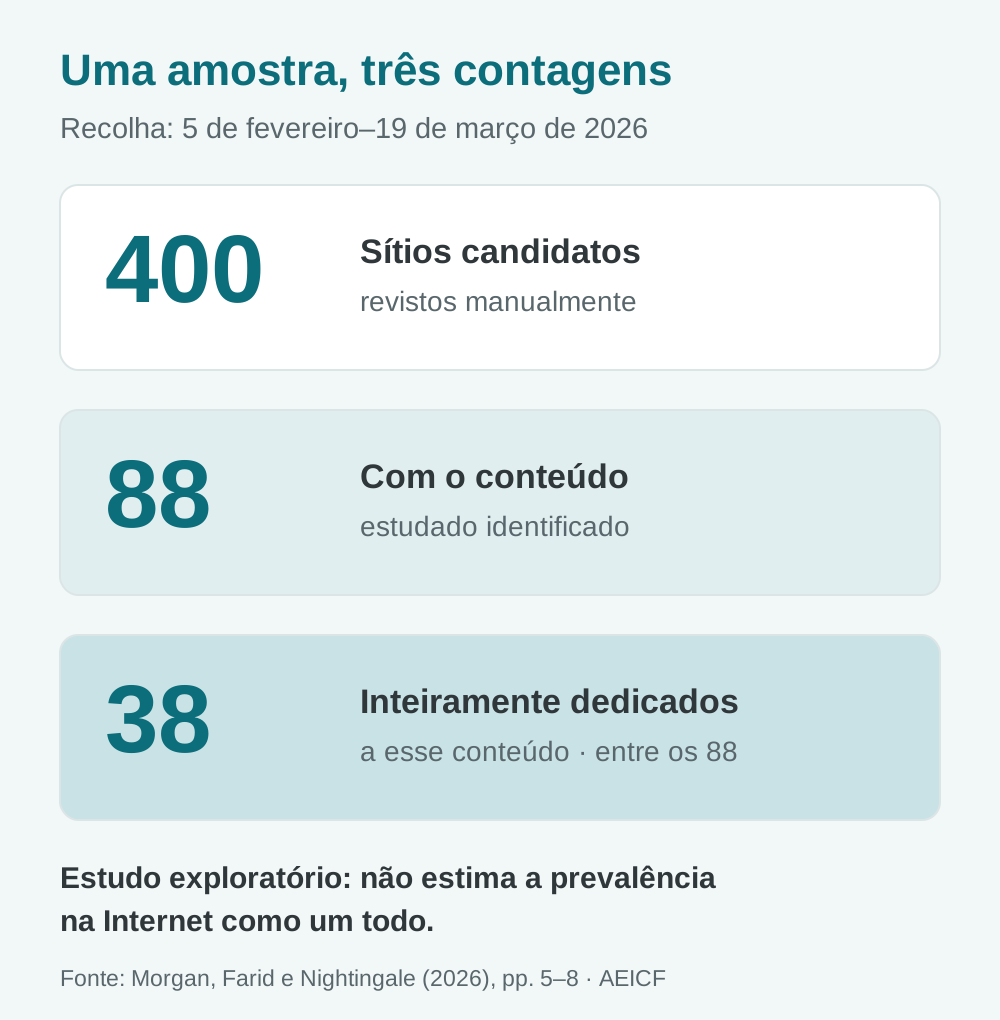
Entre 5 de fevereiro e 19 de Março de 2026, a equipa analisou manualmente 400 sites candidatos. Identificou 88 com o conteúdo estudado; 38 deles eram inteiramente dedicados a esse conteúdo. A seleção partiu de alertas e diretórios e foi alargada com ferramentas de identificação de domínios semelhantes. Centrou-se em representações de pessoas famosas e utilizou indícios do site e do conteúdo para a sua classificação. O caráter não consentido baseou-se numa presunção fundamentada sobre essas pessoas, e não numa verificação individual do seu consentimento.
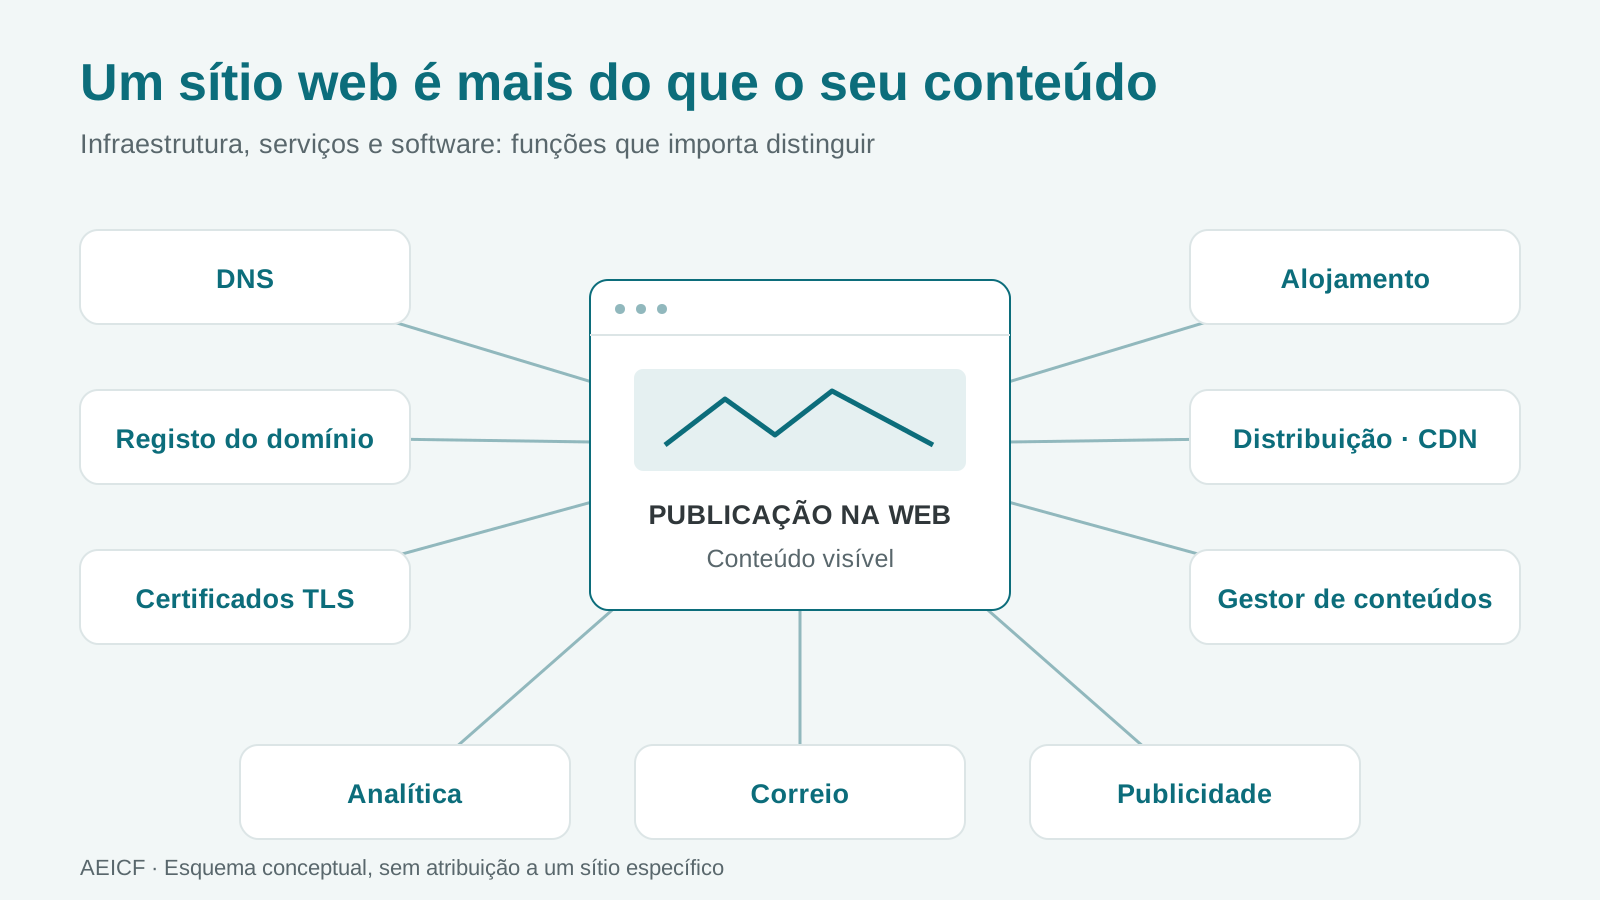
Os autores examinaram nove componentes: alojamento, redes de distribuição de conteúdo (CDN), DNS, registo de domínios, certificados SSL, gestores de conteúdos, análise de dados, correio eletrónico e publicidade. A sua análise identifica uma concentração de deteções em determinados fornecedores e tecnologias. A figura 1 e o apêndice A do artigo detalham as contagens e as bases utilizadas para cada serviço.
Três aspetos essenciais para interpretar os resultados
A amostra não equivale ao conjunto da Internet
Trata-se de um estudo exploratório, com um procedimento de pesquisa e um período de observação definidos. A seleção por domínios semelhantes pode introduzir enviesamentos; também não permite transpor diretamente os resultados para pessoas sem presença pública, espaços privados ou sites não localizados. O seu contributo consiste em descrever e tornar visível uma parte do ecossistema, não em apresentar um censo universal.
Uma percentagem precisa do seu denominador
Na categoria que o artigo designa por alojamento, Cloudflare surge em 64 das 105 identificações de fornecedores: aproximadamente 61 %. Essa base de 105 não corresponde ao número de sites. Um site pode utilizar vários serviços da mesma categoria e, noutras categorias, há informação que não foi possível identificar. Apresentar todas as proporções como percentagens dos 88 sites alteraria o significado dos resultados. Consultar a secção 4.1, a figura 1 e a tabela 1 do apêndice.
Encontrar um domínio conhecido não mede a exposição quotidiana
Os investigadores localizaram 82 dos 88 sites nas duas primeiras páginas de resultados do Google. Fizeram-no através de pesquisas construídas a partir de domínios que já conheciam, chegando a introduzir o respetivo URL completo. O resultado informa sobre a sua localização com esse protocolo; não mede a probabilidade de uma pessoa encontrar esse conteúdo através de uma pesquisa genérica. O procedimento e as suas etapas são explicados na secção 4.4, página 11.
Serviços, intermediários e software: relações diferentes
Para transpor esta linha de trabalho para a documentação forense, propomos distinguir com precisão a função observada. Um endereço IP público pode corresponder a um intermediário que recebe os pedidos e os transmite a outro servidor. Por conseguinte, a deteção desse endereço não identifica, por si só, onde está armazenado o conteúdo de origem. A documentação de Cloudflare sobre DNS e proxy inverso descreve esta separação entre a sua rede e o servidor de origem.
Algo semelhante acontece com os gestores de conteúdos. Detetar WordPress pode indicar a utilização de um programa instalado num alojamento de terceiros. Não demonstra que o site esteja alojado em WordPress.com. A documentação oficial de WordPress distingue expressamente o software de código aberto do serviço comercial de alojamento.
Estas cautelas constituem a nossa proposta de leitura técnica do estudo. Não diminuem o interesse em investigar a infraestrutura: ajudam a formular relações verificáveis. Convém separar a observação obtida da função que lhe é atribuída e de qualquer conclusão sobre controlo, conhecimento ou responsabilidade. Esta última exige provas adicionais e uma análise específica.
O que poderia acompanhar uma captura de uma página web
A questão que colocamos na AEICF é se uma captura poderia ser mais informativa ao incluir uma ficha da infraestrutura observada. Seria uma linha de trabalho a avaliar, não um procedimento que este estudo tenha validado para as nossas intervenções.
- Objeto e momento. Página ou recurso examinado, data, hora e fuso horário. Uma relação observada hoje pode ter mudado quando voltar a ser consultada.
- Observação preservada. Registo DNS, resposta HTTP, certificado apresentado ou excerto de código pertinente, juntamente com a respetiva fonte e o método de obtenção. O dado original permite rever a interpretação.
- Função atribuída. Distinguir o registo do domínio, o DNS, a intermediação, o alojamento de origem e o software detetado. Quando as provas não permitirem identificar uma função, deixá-la expressamente por determinar.
- Âmbito e alternativas. Indicar o que foi verificado, o que provém de uma ferramenta externa e que explicações continuam em aberto. Partilhar um fornecedor ou uma tecnologia não prova, por si só, que dois sites tenham o mesmo operador.
- Preservação e revisão. Documentar as ferramentas e respetivas versões, preservar os registos necessários e calcular impressões digitais de integridade. Uma impressão digital ajuda a verificar que um ficheiro não foi alterado; não comprova, por si só, que a sua interpretação esteja correta.
Antes de propor uma investigação, seria necessário verificar a reprodutibilidade das observações, o tratamento de discrepâncias entre ferramentas e a informação mínima necessária. Seria também necessário definir como proteger os dados das pessoas afetadas e evitar que a documentação amplifique a divulgação do abuso. A utilidade do contexto técnico depende tanto do que permite explicar como dos limites que deixa claros.
Leitura original e fontes
Morgan, S., Farid, H. e Nightingale, S. J. (2026). The Backbone of Abuse: How Infrastructure Providers Enable the Proliferation of AI-Generated Non-Consensual Intimate Imagery. Journal of Online Trust and Safety, 3(4). Publicado em 30 de Setembro de 2026.
- Publicação original e DOI.
- Ler o PDF completo: seleção e recolha de dados, páginas 5–8; infraestrutura e denominadores, páginas 8–9; pesquisas direcionadas, página 11; ética da investigação, páginas 25–26; tabelas de fornecedores, páginas 27–29.
- Cloudflare: funcionamento do DNS e do proxy inverso.
- WordPress: diferença entre o software e WordPress.com.
As ilustrações são esquemas originais preparados para esta leitura. O gráfico da amostra utiliza as contagens publicadas pelos autores; o esquema de infraestrutura é conceptual e não representa uma investigação sobre um site específico.